C++核心语言特性
C++核⼼语⾔特性
基础语法与概念
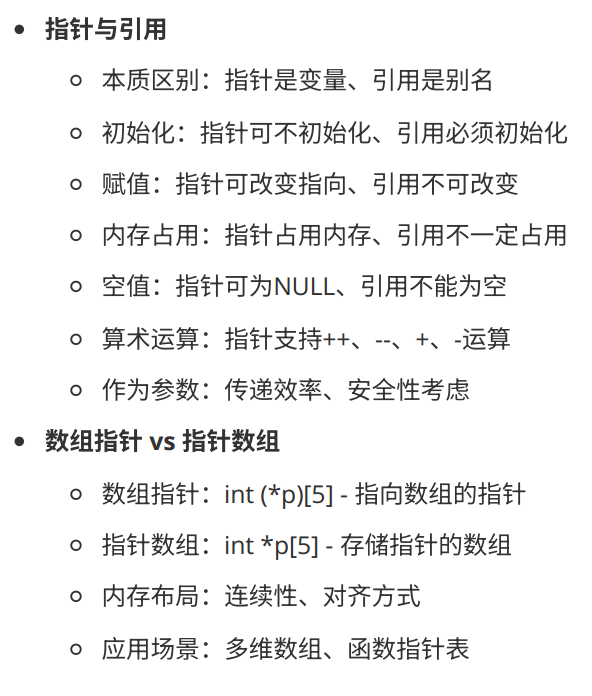
指针占用内存,为什么引用不一定占用内存
这是一个非常经典、但又容易混淆的问题。我们来一步步拆解:
✅ 一句话结论:
指针是一个变量,必须占用内存;而引用是别名,编译器在大多数情况下会把它优化为直接访问对象本身,因此不一定占用内存。
🔍 详细解释:
1. 指针是一个变量
- 指针本身是一个独立的变量,存储的是另一个对象的地址。
- 既然它是一个变量,那它就必须占用内存(通常是 4 字节或 8 字节,取决于平台)。
2
int* p = &a; // p 是一个变量,占用内存,存储的是 a 的地址2. 引用是别名,不是变量
- 引用在语义上是某个对象的别名,编译器在编译阶段会把它解析为原始对象本身。
- 在大多数情况下,编译器会优化掉引用,不会为它分配额外内存。
2
int& r = a; // r 是 a 的别名,编译器通常会直接替换成 a 本身
🧠 举个例子(汇编层面):
指针版本:
2
3
int* p = &a;
*p = 20;汇编(简化):
2
3
4
5
lea edx, [a]
mov [p], edx ; 指针变量 p 占用内存,存储地址
mov ecx, [p]
mov [ecx], 20 ; 通过指针访问引用版本:
2
3
int& r = a;
r = 20;汇编(简化):
⚠️ 注意:引用可能占用内存的情况
虽然引用通常不占用内存,但在以下情况下可能会占用内存:
引用被存储在类中(作为成员变量):
2
3
4
int& ref;
Foo(int& r) : ref(r) {}
};此时
ref必须占用内存(通常是 4/8 字节),因为它需要存储引用的对象地址。引用被捕获到 lambda 或 std::function 中:
编译器可能需要将引用包装成某种对象,间接导致内存分配。
✅ 总结一句话(再强调):
指针是变量,必须占内存;引用是别名,编译器通常优化为直接访问对象,不占内存,除非需要存储它。
如果你想,我可以给你写个小程序,用
sizeof和汇编来验证这一点。
指针到底占用多大内存
指针占用内存大小由什么决定?
指针占用的内存大小主要由操作系统和CPU架构决定,具体来说是地址总线的宽度。
- 32位系统:地址总线宽度为32位,指针占用4字节。
- 64位系统:地址总线宽度为64位,指针占用8字节。
为什么64位机器上普通指针占用8个字节?
- 64位机器的地址总线宽度为64位,可以寻址的内存空间为 (2^{64}) 字节。
- 为了表示这么庞大的地址空间,需要**8字节(64位)**的指针来存储地址。
为什么有的指针占用16个字节?
在某些特殊情况下,指针可能会占用16字节,这通常与特定的应用场景、编译器实现或特殊的指针类型有关:
- 智能指针:如
std::shared_ptr,它不仅仅是一个普通的指针,还包含一个指向控制块的指针,控制块里包含了引用计数等信息。因此,std::shared_ptr的总大小可能是16字节(两个指针的大小,一个指向对象,一个指向控制块)。- 多继承或虚继承:在复杂的继承体系中,指向对象的指针可能需要额外的信息来调整地址,以正确地访问对象的各个部分。这种调整可能需要额外的指针或信息,从而增加指针的大小。
- 特定的内存布局或对齐要求:某些系统或编译器可能对指针的对齐有特别的要求,导致指针占用的空间增加。
- 特殊的指针类型:如指向成员函数的指针,它们的大小可能与普通的对象指针不同,可能为16字节或更多,因为它们需要存储更多的信息来正确地调用函数。
总结
- 普通指针的大小主要由系统的地址总线宽度决定,64位系统上通常为8字节。
- 特殊指针类型(如智能指针、指向成员函数的指针等)可能会因为额外的功能或信息而占用更多的内存,如16字节。
当一个函数的形参是指针变量,我在调用时传入引用,或者是一个函数的形参是引用,我在调用时传入指针,会有怎样的后果呢
这是类型不匹配的问题,编译器会直接报错,不会让你“试试看后果”。
C++ 对“指针”和“引用”是两种完全不同的类别,不能隐式互换。
下面把两种错误场景拆开给你看:
- 形参是指针,你却传引用
2
3
int x = 7;
foo(x); // ❌ 编译错误:cannot convert ‘int’ to ‘int*’编译器信息(GCC):
解释:引用
x本质是对象本身,类型是int,与int*毫不兼容,没有自动转换。
- 形参是引用,你却传指针
2
3
int x = 7;
bar(&x); // ❌ 编译错误:cannot convert ‘int*’ to ‘int&’编译器信息(GCC):
解释:
&x得到的是int*,而函数要的是int&,类型不匹配;且指针值是右值,不能绑定到非 const 引用。
✅ 正确写法
形参类型 调用时给什么 int*传 &x或同类型指针变量int&传 x本身(对象)
一句话总结
指针与引用在语法层面互不兼容,传错即编译失败;想“混用”必须手动解址或取址,并保证类型完全匹配。
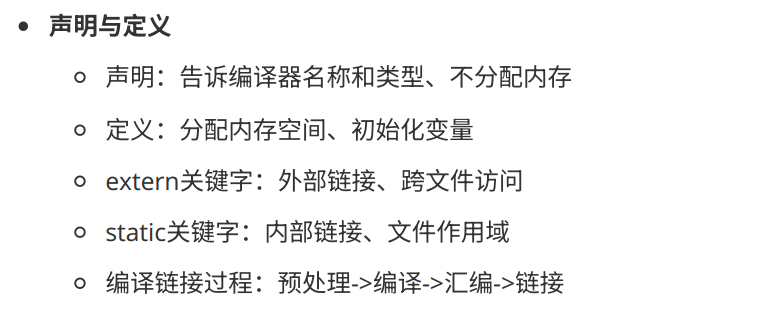
类内static和类外static有什么区别
一句话先答
- 类内 static:属于类而不属于某个对象,只在这一份类定义里共享。
- 类外 static:属于当前翻译单元(.cpp 文件)的内部链接,别的源文件看不见。
下面把“生命周期、存储位置、链接属性、访问方式”逐项拆开对比,一看就懂。
维度 类内 static 成员 类外 static(全局/函数内) 所属实体 类本身 当前源文件(翻译单元) 存储期 静态/程序整个运行期 同上 物理位置 数据段(.bss/.data) 同上 链接属性 外部链接(符号名带类作用域) 内部链接(符号对外不可见) 能否跨文件访问 可以(通过类名::成员,且需要类外定义) 不可以(其他 .cpp 看不到) 是否需要类外定义 必须(在 .cpp 里再写一次定义,除非 C++17 内联变量) 不需要(本身就是定义) 典型用途 计数实例、类级常量、单例指针等 当前文件私有的全局变量/函数 示例 class A{ static int cnt; };static int g_cnt;或static void helper(){}再补两句容易踩坑的
- 类内 static 不是“每个对象一份”,而是整个程序只有一份。
- 类外 static 与匿名 namespace 效果类似,都是“内部链接”,但符号名仍占空间;C++ 项目里更推荐用匿名 namespace 代替老式的文件级 static。
记住口诀:
“类内 static 给类用,类外 static 给文件用。”
关键字深度理解
static关键字
局部静态变量:⽣命周期延⻓、只初始化⼀次
全局静态变量:⽂件作⽤域、内部链接性
静态成员变量:类共享、存储在数据段
静态成员函数:不能访问⾮静态成员、没有this指针
应⽤场景:单例模式、计数器、⼯⼚函数const关键字
const变量:编译期常量、运⾏期常量
const指针:const int *p vs int * const p vs const int * const p
const成员函数:不修改对象状态、可被const对象调⽤
const对象:只能调⽤const成员函数
mutable关键字:在const成员函数中修改成员变量
const_cast:去除const属性(危险操作)volatile关键字
编译器优化阻⽌:防⽌编译器优化掉变量访问
内存可⻅性:告诉编译器变量可能被外部修改
应⽤场景:硬件寄存器、信号处理、多线程共享变量
与atomic区别:volatile不保证原⼦性
与const关系:const volatile组合使⽤virtual关键字
虚函数机制:动态绑定、运⾏时多态
虚函数表(vtable):每个类⼀个vtable、虚函数指针数组
虚函数指针(vptr):每个对象包含vptr、指向对应vtable
纯虚函数:= 0声明、抽象基类、不能实例化
虚析构函数:基类指针删除派⽣类对象、防⽌内存泄漏
虚继承:解决菱形继承、共享基类实例inline关键字
内联函数原理:编译时代码替换、减少函数调⽤开销
优点:性能提升、避免函数调⽤开销缺点:代码膨胀、编译时间增加、调试困难
内联失效:递归函数、虚函数、函数指针调⽤
编译器优化:现代编译器⾃动内联优化
最佳实践:⼩函数、频繁调⽤、不超过10⾏代码explicit关键字
防⽌隐式转换:单参数构造函数、转换运算符
使⽤场景:避免意外的类型转换、提⾼代码安全性
explicit构造函数:必须显式调⽤构造函数
explicit转换运算符:C++11新特性
最佳实践:除⾮确实需要隐式转换,否则都加explicit
好的,我们来详细展开讲解这些C++核心关键字和概念。这对于理解C++的底层机制和编写高质量代码至关重要。
1. static 关键字
static 的含义是“静态的”,它在不同上下文中有不同的作用,但核心思想是与特定实例解耦,具有“唯一性”和“持久性”。
a. 局部静态变量 (Local Static Variables)
生命周期延长: 普通局部变量在函数调用结束时被销毁。而局部静态变量的生命周期从第一次执行声明语句开始,直到整个程序结束。
只初始化一次: 初始化语句(如
static int x = 5;)仅在第一次执行时进行,后续的函数调用会跳过初始化,直接使用之前的值。存储位置: 存储在全局数据区(数据段),而非栈区。
应用场景: 用于在函数调用之间保持状态,比如计数器、第一次使用的延迟初始化(Meyers’ Singleton)。
1
2
3
4
5
6
7
8
9
10
11void counter() {
static int count = 0; // 只初始化一次
count++;
std::cout << count << std::endl;
}
int main() {
counter(); // 输出 1
counter(); // 输出 2
counter(); // 输出 3
return 0;
}
b. 全局静态变量/函数 (Global Static Variables/Functions)
文件作用域 (File Scope): 用
static修饰的全局变量或函数,其链接性 (Linkage) 为内部链接性。内部链接性: 这意味着该变量/函数仅在定义它的源文件(.cpp)内可见,其他源文件无法通过
extern声明来访问它。这有效避免了命名冲突和意外的跨文件访问,是封装性的体现。与普通全局变量的区别: 普通全局变量是
extern(外部链接性)的,所有源文件可见,容易造成命名污染。1
2
3
4
5
6// File1.cpp
static int localVar = 42; // 只在 File1.cpp 中可见
static void localFunc() {} // 只在 File1.cpp 中可见
// File2.cpp
extern int localVar; // 错误!无法链接到 File1.cpp 的 localVar
c. 静态成员变量 (Static Member Variables)
类共享: 它不属于任何一个类的对象,而是属于整个类。所有该类的对象共享同一份静态成员变量。
存储在数据段: 和全局变量一样,存储在程序的数据段。
初始化: 必须在类外(通常在源文件.cpp中)进行单独的定义和初始化(编译器需要为其分配存储空间)。
应用场景: 统计类创建的对象数量、类的配置参数、所有对象共享的缓存等。
1
2
3
4
5
6
7
8
9
10
11class MyClass {
public:
static int count; // 声明
MyClass() { count++; }
};
int MyClass::count = 0; // 定义并初始化(必须放在类外)
int main() {
MyClass obj1, obj2;
std::cout << MyClass::count; // 输出 2
}
d. 静态成员函数 (Static Member Functions)
没有
this指针: 因为它不属于任何特定对象,所以没有this指针。只能访问静态成员: 正因为没有
this,它无法直接访问类的普通成员变量和函数(这些都需要通过this指针来访问)。它只能访问其他的静态成员(变量或函数)。调用方式: 可以通过类名直接调用(
ClassName::StaticFunction()),也可以通过对象调用(obj.StaticFunction())。应用场景: 用于操作静态成员变量、创建工具函数、工厂函数(不依赖对象状态)。
1
2
3
4
5
6
7class MyClass {
static int s_value;
int value;
public:
static int getStatic() { return s_value; } // OK
static int getValue() { return value; } // 错误!无法访问非静态成员
};
应用场景总结
单例模式 (Singleton): 利用局部静态变量实现线程安全的单例(C++11后)。
1
2
3
4
5
6
7
8
9
10
11
12class Singleton {
public:
static Singleton& getInstance() {
static Singleton instance; // 保证只初始化一次
return instance;
}
// 删除拷贝构造函数和赋值运算符
Singleton(const Singleton&) = delete;
Singleton& operator=(const Singleton&) = delete;
private:
Singleton() {} // 私有化构造函数
};计数器: 如上文例子,统计对象数量。
工厂函数: 静态成员函数可以根据输入参数创建并返回不同的对象。
2. const 关键字
const 的含义是“常量”,它告诉编译器和一个意图:这个对象或值不应该被修改。编译器会帮你 enforcing(强制执行)这个规则。
a. const变量
- 编译期常量 (Compile-time Constant): 值在编译期就知道(如
const int size = 100;),可以用来定义数组大小。它可能被编译器优化,直接用值替换。 - 运行期常量 (Run-time Constant): 值在运行时才能确定(如
const int x = getValue();),仍然是只读的。
b. const指针 - 区分原则:const 在 * 的左边还是右边
const int *p(或int const *p): 指向常量的指针 (Pointer to const)。p指向的内存内容不可通过p修改,但p本身可以指向别的地址。const int *p = &a; *p = 10; // 错误! p = &b; // 正确int * const p: 常量指针 (Const pointer)。p本身(存储的地址)不可修改,但它指向的内存内容可以修改。int * const p = &a; p = &b; // 错误! *p = 10; // 正确const int * const p: 指向常量的常量指针。p本身和它指向的内容都不可修改。
c. const成员函数
不修改对象状态: 在成员函数声明的参数列表后加上
const,承诺这个函数不会修改调用它的对象的任何非静态成员变量(除非成员被mutable修饰)。可被const对象调用: const对象只能调用const成员函数,这是保证对象状态不被修改的关键机制。
重载依据:
void func() const;和void func();可以构成重载。const对象调用const版本,非const对象调用非const版本。1
2
3
4
5
6
7
8
9
10class MyClass {
int value;
mutable int cache; // 即使在const函数中也可被修改
public:
int getValue() const { // const成员函数
// value = 10; // 错误!不允许修改成员
cache = 20; // 正确,因为cache是mutable的
return value;
}
};
d. const对象
const MyClass obj;- 对象自创建后,其所有成员变量的值都不能再被修改。
- 只能调用该对象的const成员函数。
e. mutable 关键字
- 突破const限制: 用于修饰类的成员变量。被
mutable修饰的变量,即使在const成员函数中,也可以被修改。 - 应用场景: 用于一些不影响对象“逻辑状态”的成员,例如缓存(cache)、调试计数、互斥锁(mutex,因为加锁解锁操作本身就需要改变锁的状态)。
f. const_cast 运算符
去除const属性:
const_cast<Type&>(const_object)可以去除对象的const限定符。危险操作: 只能用在你确定一个原本不是const的对象被const引用指向了,而现在需要修改它时。如果原对象本身是const的,修改它是未定义行为 (Undefined Behavior),通常会导致程序崩溃。
1
2
3
4
5
6void print(char *str) { std::cout << str; }
int main() {
const char *c = "hello";
// print(c); // 错误:无法将‘const char*’转换为‘char*’
print(const_cast<char*>(c)); // 危险!但如果字符串字面量是只读的,这可能崩溃。
}
3. volatile 关键字
volatile 的含义是“易变的”,它主要目的是阻止编译器进行激进的优化,因为变量可能会被程序本身之外的因素改变。
a. 编译器优化阻止
- 编译器优化通常会把频繁访问的变量值加载到寄存器中,后续访问直接读寄存器,以提高速度。
- 对于
volatile变量,编译器每次必须从内存中重新读取它的值,而不是使用寄存器中的缓存。写操作也必须立即写回内存。
b. 内存可见性
- 告诉编译器,这个变量的值可能在任何时候被外部硬件、操作系统内核、或其他线程改变。因此,不能对它的访问做假设。
c. 应用场景
- 硬件寄存器: 映射到内存地址的硬件设备寄存器(如状态寄存器),其值由硬件设备改变。
- 信号处理: 在信号处理函数中修改的全局变量。
- 多线程共享变量 (传统方式,现已不推荐): 在缺乏其他同步机制(如
std::atomic或mutex)的老代码中,用于标记被多个线程共享的变量。注意:volatile不能替代现代的线程同步工具!
d. 与 std::atomic 的区别
这是非常重要的区别!
| 特性 | volatile |
std::atomic |
|---|---|---|
| 原子性 | 不保证 | 保证 |
| 内存顺序 | 不保证(乱序执行可能发生) | 提供严格的内存顺序保证(如memory_order_relaxed等) |
| 主要目的 | 禁用编译器优化,保证每次访问内存 | 提供多线程环境下的安全、无数据竞争的访问 |
简单说:volatile 解决的是“编译器不知道值会变”的问题,而 atomic 解决的是“CPU执行时可能发生数据竞争”的问题。 在现代C++多线程编程中,应该使用 std::atomic 来保护共享数据。
e. 与 const 的关系
可以组合使用:const volatile int* p;
这表示 p 指向一个既是常量又是易变的内存位置。
- 程序不能通过
p修改它(const)。 - 但它的值可能被外部改变,所以编译器不能优化对其的访问(volatile)。
- 场景: 指向一个只读硬件状态寄存器的指针。
4. virtual 关键字
virtual 用于实现 C++ 的动态多态(运行时多态),是面向对象编程的核心。
a. 虚函数机制 (Virtual Functions)
- 动态绑定 (Dynamic Binding) / 晚期绑定 (Late Binding): 使用基类的指针或引用来调用一个虚函数时,程序会在运行时根据该指针或引用实际指向的对象的类型来决定调用哪个版本的函数(基类还是派生类的)。
- 与静态绑定的区别: 非虚函数在编译期就根据指针/引用的类型确定了要调用的函数。
b. 虚函数表 (vtable) 和虚函数指针 (vptr)
这是实现多态的底层机制。
- 虚函数表 (vtable): 编译器会为每一个包含虚函数的类生成一个虚函数表。它是一个函数指针数组,存放着这个类所有虚函数的地址。
- 虚函数指针 (vptr): 编译器会为每一个包含虚函数的类的对象隐式地添加一个指针成员(vptr)。在对象构造时,这个vptr会被设置为指向该对象所属类的vtable。
- 调用过程: 当通过基类指针调用虚函数
p->func()时,编译器会生成代码:- 通过
p找到对象的 vptr。 - 通过 vptr 找到类的 vtable。
- 在 vtable 中找到
func的地址。 - 调用该地址的函数。
- 通过
c. 纯虚函数 (Pure Virtual Functions) 和抽象基类 (Abstract Base Classes)
- 纯虚函数: 在声明末尾加上
= 0(如virtual void func() = 0;)。该类抽象基类。 - 抽象基类: 包含至少一个纯虚函数的类。它不能创建实例对象。它的作用是定义接口,强制其派生类去实现这些接口。
d. 虚析构函数 (Virtual Destructors)
为什么重要: 如果基类的析构函数不是虚的,那么当你
delete一个基类指针(该指针实际指向一个派生类对象)时,只会调用基类的析构函数,而不会调用派生类的析构函数,导致派生类的资源泄漏。规则: 如果一个类打算被继承(作为基类),那么它的析构函数必须声明为虚函数。
1
2
3
4
5
6
7
8
9
10
11
12class Base {
public:
virtual ~Base() { std::cout << "Base dtor\n"; } // 虚析构函数
};
class Derived : public Base {
public:
~Derived() { std::cout << "Derived dtor\n"; }
};
int main() {
Base* p = new Derived();
delete p; // 输出: Derived dtor \n Base dtor
}
e. 虚继承 (Virtual Inheritance)
解决问题: 菱形继承(Diamond Problem) 导致的二义性和数据冗余。
1
2
3
4
5A
/ \
B C
\ /
D普通继承下,
D类会包含两份A类的成员。虚继承: 让
B和C虚继承自A(class B : virtual public A)。这样,在D中只会保留一份A的实例。D负责直接初始化A。
5. inline 关键字
inline 是对编译器的建议,建议将函数调用展开为函数体本身的代码,以消除函数调用的开销。
a. 原理
- 编译器在编译时,尝试将
inline函数的代码直接插入到每一个调用点,从而避免函数调用(参数压栈、跳转、返回等)的开销。 - 最终是否内联,由编译器决定。
inline关键字只是一个强烈的暗示。
b. 优点
- 性能提升: 对于短小精悍、频繁调用的函数,消除函数调用开销能带来性能提升。
c. 缺点
- 代码膨胀: 如果函数体很大且在多个地方被调用,内联会导致最终的可执行文件体积显著增大。这可能会降低指令缓存命中率,反而降低性能。
- 编译时间增加: 头文件中定义的函数通常需要被内联,这意味着函数实现放在头文件中,任何包含该头文件的源文件修改都会导致该函数被重新编译。
- 调试困难: 内联函数没有清晰的调用栈。
d. 内联失效的情况(编译器通常不会内联)
- 递归函数
- 函数体内包含循环或复杂控制流(switch, goto)
- 通过函数指针调用的函数
- 虚函数(因为运行时才能确定调用哪个,无法在编译期展开)
e. 现代编译器的优化
现代编译器非常智能,即使没有 inline 关键字,也会自动对合适的函数进行内联优化。反之,即使你写了 inline,编译器也可能拒绝内联。
f. 最佳实践
- 将小(如1-5行)、频繁调用、不复杂的函数声明为
inline。 - 通常将
inline函数的定义直接放在头文件(.hpp)中。 - 优先使用类内定义的成员函数,它们默认是内联的候选。
6. explicit 关键字
explicit 用于修饰构造函数或转换函数,防止编译器进行隐式类型转换,要求代码必须是显式的。
a. 防止隐式转换
单参数构造函数: 过去,如果一个构造函数只需要一个参数,它就成为一个隐式转换函数。这可能导致意外的行为。
1
2
3
4
5
6
7
8
9
10class MyString {
public:
MyString(int size) { ... } // 允许从int隐式转换为MyString
};
void displayString(const MyString& s) { ... }
int main() {
displayString(10); // 编译器会隐式调用 MyString(10)!这可能不是我们想要的。
displayString("hello"); // 错误,没有匹配的构造函数
}加上
explicit后:1
2
3
4
5
6
7
8
9
10class MyString {
public:
explicit MyString(int size) { ... }
};
void displayString(const MyString& s) { ... }
int main() {
// displayString(10); // 错误!不允许隐式转换
displayString(MyString(10)); // 正确,必须显式转换
}转换运算符 (C++11): C++11 允许对转换运算符也使用
explicit。1
2
3
4
5
6
7
8
9
10
11
12class SmartBool {
bool value;
public:
explicit operator bool() const { // 显式转换为bool
return value;
}
};
SmartBool sb;
// if (sb) ... // 正确:在if/while等语境下,上下文转换是允许的
// bool b = sb; // 错误:需要显式转换
// int i = sb + 1; // 错误:需要显式转换
bool b = static_cast<bool>(sb); // 正确:显式转换
b. 最佳实践
- 除非你有充分的理由需要隐式转换,否则应将单参数构造函数都声明为
explicit。这可以提高代码的安全性、可读性和可维护性,避免难以察觉的bug。 std::vector的explicit vector(size_type count)就是一个经典例子,防止了void f(const vector<int>& v); f(10);这种意外的调用(本意可能是创建一个包含10个元素的vector,但实际可能是想调用f(10)?这很可能是错误)。
内存管理
new/delete操作符:new operator、operator new、placement new区别
把这三兄弟拆成 **“名字像、分工不同”** 的三层,一张表先看清:
名字 本质 谁提供的 干的事 会不会调构造函数 new operator(俗称 new 表达式)语言内置表达式 编译器 ①调 operator new分配内存 ②调构造函数✅ operator new可重载函数 标准库/你自己 只分配原始未初始化内存,像 malloc❌ placement newoperator new的重载版本标准库 在已有一块内存上“构造”对象,不分配 ✅(只干构造)
1.
new operator—— 我们天天写的T* p = new T;
2
3
Foo* p = static_cast<Foo*>(raw);
new(p) Foo(123); // ② 构造(调用 placement new)
- 你不能阻止它调构造函数,也无法改变这两步顺序。
- 想只换“分配方式”——重载
operator new;
想连“构造方式”也干预——自己写placement new并手动两步。
2.
operator new—— 纯粹的“内存分配器”
- 返回值是
void*,不会调构造函数。- 可全局重载,也可给类单独重载:
2
3
4
static void* operator new(std::size_t n); // 只影响 Foo 的 new 表达式
static void operator delete(void* p);
};
- 对应释放函数是
operator delete,同理只释放内存,不析构。
3.
placement new—— “定点构造”神器标准库提供的重载之一:
2
3
char buf[sizeof(Foo)]; // 栈上/共享内存/池里已有一块内存
Foo* p = new (buf) Foo(42); // 只在 buf 上调用构造函数
- 不分配、不释放,只返回那块地址并调构造函数。
- 对象用完必须手动调用析构:
2
// 内存归你管,后续再用或释放都自己决定
- 名字 “placement” 就是“放置”之意——“把对象放到我指定的地方”。
一张图总结流程
2
3
├─→ operator new(sizeof(Foo)) 分配
└─→ placement new(ptr) Foo(123) 构造
常见误区提醒
placement new出来的对象禁止直接用delete!
会重复释放同一块内存 → UB。
正确:先显式析构,再自己处理那块内存。数组版本也有对应物:
new Foo[n]→operator new[]→placement new[](少见,原理相同)。全局重载
operator new影响所有 new 表达式,慎用;类作用域重载只影响该类。记住三句话:
- new 表达式 = 分配 + 构造,一步到位。
- operator new = 裸分配,可重载,不构造。
- placement new = 只构造,不分配,内存你说了算。
智能指针:shared_ptr、unique_ptr、weak_ptr实现原理讲解一下
把三种智能指针拆成“一条时间线 + 一张控制块图 + 三条代码路径”,就能一次性看懂它们的核心原理。
一、共享所有权模型总览(64 位机器为例)
1 | ┌----------------------┐ |
- control block 与对象可以分块(
make_shared会把它们拼成一整块,性能更好)。 - 两个原子计数:
–shared_count:有多少个shared_ptr活着。
–weak_count:有多少个weak_ptr活着;当shared_count==0时对象析构,但 control block 要等weak_count==0才释放。
二、逐个拆解实现原理
shared_ptr<T>—— “引用计数的句柄”
1 | template<class T> |
- 拷贝=原子++,析构=原子–;减到 0 才真正
delete对象。 - 线程安全:引用计数操作用
atomic_fetch_add/sub,但对象本身不互斥。
weak_ptr<T>—— “非拥有观察器”
1 | template<class T> |
weak_ptr只改weak_count,不干扰对象生命周期。lock()用 CAS 把shared_count从 0 以上加 1,保证线程安全地“提升”成shared_ptr。
unique_ptr<T,Deleter>—— “独占 + 可定制删除器”
1 | template<class T, class D = default_delete<T>> |
- 零开销:和裸指针一样大(
sizeof(unique_ptr<T>) == sizeof(T*))。 - 无原子操作,不可替代拷贝,只能
move,因此性能 = 手工new/delete。 - 删除器类型可以是函数指针、lambda、函数对象,用
[[no_unique_address]]空基优化,不额外占空间。
三、一张图秒记
1 | 生命周期\指针类型 unique_ptr shared_ptr weak_ptr |
四、使用场景一句话
- unique_ptr:独占资源,成本最低,首选。
- shared_ptr:真·共享所有权(如多线程缓存节点、回调链)。
- weak_ptr:打破环、缓存观察、避免悬空访问。
记住这条链:
“unique 优先,非共享不用 shared;shared 一用,weak 随时准备破环。”
内存泄漏:检测⽅法、防⽌策略、调试⼯具(Valgrind)
下面给出一套“开发期→测试期→线上期”全链条的内存泄漏治理方案:
先讲检测思路→防止策略→实战调试工具(Valgrind 为例),最后附一条“一键脚本”直接定位泄漏行号。
一、检测方法:3 层过滤
| 阶段 | 手段 | 成本 | 是否能定位行号 |
|---|---|---|---|
| 编译期 | 静态分析(clang-tidy / cppcheck) | 零运行开销 | ❌(只能给提示) |
| 测试期 | 动态插桩(Valgrind / ASan) | 2~10× 降速 | ✅ 精确到行 |
| 线上期 | 采样 + 统计(jemalloc stats / gperftools heap-profiler) | <5% 损耗 | ✅ 近似栈 |
二、防止策略:代码层面 5 条铁规
RAII 全覆盖
资源放在构造函数里获取,析构里释放;用std::unique_ptr/std::vector代替裸new[]/malloc。** ownership 可视化**
函数签名里用std::unique_ptr<T>表示独占,std::shared_ptr<T>表示共享,裸指针T*仅作非拥有观察。禁用危险接口
全局加-Werror=deprecated-declarations,把strdup/getline/malloc等 C 接口封装到std::string/std::vector。循环引用破环
父子对象用weak_ptr回指;异步回调用weak_from_this()+lock()提升。单元测试必跑泄漏检查
在 CI 里把测试可执行文件跑在 Valgrind/ASan 下,阈值 >0 字节即判失败。
三、调试工具:Valgrind 三行命令定位泄漏
安装
Ubuntu:sudo apt install valgrind
CentOS:sudo yum install valgrind最常用模式
1
2valgrind --leak-check=full --show-leak-kinds=all --track-origins=yes \
./your_program arg1 arg2参数说明
--leak-check=full:给出每次泄漏的完整栈。--track-origins=yes:告诉你未初始化值是哪一行产生的。--show-leak-kinds=all:区分definitely/indirectly/possibly/still reachable。
结果解读示例
1
2
3
4==1234== 40 bytes in 1 blocks are definitely lost in loss record 1 of 2
==1234== at 0x4C2BBAF: malloc (vg_replace_malloc.c:299)
==1234== by 0x4006ED: foo() (main.cpp:8)
==1234== by 0x40070E: main (main.cpp:13)关键词
definitely lost表示确定泄漏;直接跳到main.cpp:8就能看见忘了delete的那一行。生成抑制文件(去掉系统库误报)
1
2
3valgrind --gen-suppressions=all --leak-check=full ./your_program 2> valgrind.supp
# 以后跑
valgrind --suppressions=valgrind.supp --leak-check=full ./your_programCI 集成阈值检查
1
2valgrind --error-exitcode=42 --leak-check=full ./your_program
# 只要泄漏 >0 字节,Valgrind 返回 42,CI 直接红灯。
四、一条“一键脚本”自动抓泄漏行号
把下面脚本扔进 .github/workflows/valgrind.yml 即可在 GitHub Actions 里跑:
1 | name: memcheck |
五、速查表:泄漏场景 vs 工具选择
| 场景 | 推荐工具 | 备注 |
|---|---|---|
| 本地快速冒烟 | AddressSanitizer(-fsanitize=address) |
1.5× 速度,集成 GDB |
| 单元测试阶段 | Valgrind | 最详细,能抓未初始化读写 |
| 压力测试/长稳 | gperftools heap-profiler + jemalloc | 采样,损耗低 |
| 嵌入式/交叉编译 | Clang LeakSanitizer(无 Valgrind 时) | 需要 gcc/clang 5.0+ |
口诀记住:
“代码里先 RAII,测试里跑 Valgrind,线上用采样 profiler;三步走完,泄漏归零。”
野指针与悬空指针:产⽣原因、危害、避免⽅法
好的,我们来深入探讨C++中两个非常棘手且危险的概念:野指针 (Wild Pointer) 和 悬空指针 (Dangling Pointer)。
它们都是指向无效内存地址的指针,是导致程序崩溃、数据损坏、以及难以调试的“未定义行为”的常见根源。
野指针 (Wild Pointer)
1. 产生原因
野指针指的是未被初始化或指向未知随机地址的指针。 它指向哪里是完全不确定的。
声明后未初始化: 这是最常见的原因。指针变量在声明时不会自动初始化为
nullptr,它的值是之前栈内存上的随机垃圾数据。
2
*wildPtr = 10; // 灾难!向一个未知的内存地址写入数据指针变量本身在栈上,但未初始化:
2
3
4
int* p; // p在栈上,但其值(指向的地址)是未定义的垃圾值,是野指针。
// ...
}2. 危害
- 未定义行为 (Undefined Behavior): 对野指针进行解引用(读写操作)的行为是未定义的。
- 程序崩溃: 如果指针指向的随机地址是操作系统保护的内存区域(如内核空间),会立即触发段错误(Segmentation Fault)或访问冲突(Access Violation),导致程序崩溃。
- 数据损坏: 如果指针恰好指向程序可写的内存地址(如另一个变量所在的位置),写入操作会静默地覆盖那块内存的数据,导致程序行为异常,且这种bug极难追踪。
3. 避免方法
核心思想:让所有指针在创建时都有一个明确的、有效的或可知的状态。
声明时立即初始化:
- 如果暂时不知道指向什么,立即初始化为
nullptr。
在指针生命周期结束后置空: 虽然作用有限,但在复杂逻辑中,
delete一个指针后立即将其置为nullptr是一个好习惯,可以防止意外地重复delete或误用。
2
ptr = nullptr; // 现在ptr不是野指针,而是空指针使用智能指针: 这是现代C++最根本、最推荐的解决方案。
std::unique_ptr和std::shared_ptr等智能指针在构造时会被自动初始化(要么指向有效对象,要么为nullptr),在析构时会自动释放内存,并且释放后会自动置空,从根本上避免了野指针和悬空指针的产生。
悬空指针 (Dangling Pointer)
1. 产生原因
悬空指针指的是指针曾经指向一个有效的内存地址,但该内存后被释放或失效,而这个指针仍然保留着原来的地址。 它像一个“晃来晃去”的指针,指向一个“已死亡的”对象。
释放/删除后未置空: 这是最典型的场景。使用
delete(对于C的free也一样)释放了堆内存,但指针变量本身依然存在并存储着那个已经失效的地址。
2
3
4
delete ptr; // 内存被释放,ptr现在变成了悬空指针
// ptr still holds the address that is no longer valid
*ptr = 20; // 灾难!向已释放的内存写入数据指向局部变量(栈内存): 函数返回后,其栈帧被销毁,所有局部变量失效。指向这些局部变量的指针在函数外部就变成了悬空指针。
2
3
4
5
6
7
int value = 10;
return &value; // 错误!返回局部变量value的地址
}
int* danglingPtr = createInt(); // danglingPtr是悬空指针
// value的生命周期已在createInt()返回时结束
std::cout << *danglingPtr; // 未定义行为!读取已销毁的栈内存多个指针指向同一资源,其中一个释放了资源: 如果有多个指针指向同一块动态分配的内存,通过其中一个指针
delete了内存,其他所有指针都会立即变为悬空指针。
2
3
4
5
6
7
8
int* ptr2 = ptr1; // ptr1和ptr2指向同一块内存
delete ptr1; // 内存被释放
ptr1 = nullptr; // ptr1被置空,是安全的
// 但ptr2对此一无所知,它现在是一个悬空指针!
std::cout << *ptr2; // 未定义行为!2. 危害
- 未定义行为: 与野指针相同,解引用悬空指针是未定义行为。
- 程序崩溃: 访问已释放的内存很可能导致程序崩溃。
- 数据损坏与安全漏洞: 危害比野指针更大,因为这块内存可能已经被内存分配器重新分配并存放了其他数据。对悬空指针的写入会破坏这些新数据,可能导致极其诡异的bug,甚至在特定条件下可能被利用形成安全漏洞(如Use-After-Free漏洞)。
3. 避免方法
核心思想:确保指针的生命周期不超过其所指对象的内存生命周期。
- 释放后立即置空: 这是一个“治标”的方法。
delete ptr;后紧跟ptr = nullptr;。这样即使再次误用,对空指针解引用也会立即导致崩溃(这比破坏其他数据更容易调试)。但这无法解决多个指针指向同一资源的问题。- 严格控制指针的作用域: 让指针的寿命短于或等于其所指对象的寿命。例如,避免返回指向局部变量的指针或引用。
- 使用智能指针: 同样是现代C++最根本的解决方案。
std::unique_ptr: 明确表达所有权的独占性。一块内存只由一个unique_ptr管理,不可能出现多个指针。当unique_ptr离开作用域,内存自动释放,并且所有指针信息都被清理。从根本上杜绝了多个指针的问题。std::shared_ptr: 使用引用计数来管理共享所有权。只有当最后一个shared_ptr被销毁时,内存才会被释放。这完美解决了“多个指针指向同一资源”的悬空问题。- 使用引用代替指针: 当你不需要“无指向”或“重指向”的能力时,优先使用引用。引用必须在创建时绑定到一个有效对象,且不能重新绑定,因此它天然不会出现悬空或野的状态(尽管通过某些奇技淫巧仍然可能创建出无效引用,但那不是常规用法)。
总结与对比
特性 野指针 (Wild Pointer) 悬空指针 (Dangling Pointer) 本质 未初始化的指针,值是随机的 已初始化但指向已失效内存的指针 产生时机 创建时 资源释放后 常见原因 声明后未初始化 1. delete/free后未置空
2. 指向已销毁的栈对象
3. 多个指针指向同一资源,其中一个释放危害 程序崩溃、数据损坏 程序崩溃、数据损坏、安全漏洞 根本解决方法 声明时初始化为 nullptr使用智能指针管理资源生命周期 最佳实践:
- 永远初始化指针: 声明指针时,要么赋予它有效的地址,要么立即赋值为
nullptr。- 释放后立即置空: 使用
delete或free后,养成习惯将指针置空。- 优先使用引用: 如果不需要指针的灵活性,使用引用更安全。
- 拥抱现代C++: 尽可能地使用
std::unique_ptr和std::shared_ptr来代替裸指针(raw pointer)管理资源所有权。 这是避免内存管理错误的最有效手段。将裸指针仅用于“观察”而非“拥有”资源的场景。
字节对⻬:原理、pragma pack、性能影响
字节对齐:原理、pragma pack、性能影响
一、原理:硬件说了算
对齐定义
数据类型 T 的地址必须是alignof(T)的倍数,否则:- CPU 抛总线错误(ARM、RISC-V)
- 或自动拆成多次内存访问 → 性能掉崖(x86 允许,但慢)。
自然对齐
1
2
3
4
5char → 1 字节
short → 2 字节
int → 4 字节
long/double → 8 字节(64 位)
__m256i → 32 字节(AVX)结构体对齐规则(Itanium C++ ABI)
a. 成员各自对齐到min(自身对齐, 当前 pack 值)
b. 结构体总大小对齐到“最大对齐成员”的倍数(同样受 pack 裁剪)
c. 数组按元素对齐。
二、#pragma pack:手动改规则
语法
1 |
|
实例:
1 |
|
相同功能的标准化写法(C++11 起)
1 | struct [[gnu::packed]] A { ... }; // GCC/Clang |
三、性能影响:一张图看懂
| 对齐 | 内存占用 | 单次访存 | SIMD 加载 | 缓存行污染 | 结论 |
|---|---|---|---|---|---|
| 自然对齐 | 大(填充) | 1 周期 | 直接 movaps | 无 | 最快 |
| pack(1) | 最小 | 2~4 周期拆分 | 崩溃/手动 movups | 可能跨行 | 最省 |
| pack(2) | 中 | 短地址 OK | 部分失败 | 中 | 折中 |
- x86:硬件容忍,但跨 cache-line 访问带宽减半。
- ARM:未对齐触发
SIGBUS,必须__builtin_assume_aligned或手动拷贝。 - SIMD:256/512-bit 指令要求 32/64 字节对齐,否则直接异常。
四、最佳实践口诀
- 默认让编译器对齐;
- 网络/磁盘协议用
#pragma pack(push, 1)立即还原; - 热路径结构体把大成员放前面,避免空洞;
- 与 SIMD 交互时加
alignas(32)并static_assert(alignof(T) == 32); - 嵌入式解压后转本地副本,别再全程 packed 跑。
五、一条命令看真实布局
1 | g++ -fdump-lang-class -std=c++17 test.cpp # GCC 打印填充细节 |
输出示例
1 | struct A { |
记住:“pack 省空间,对齐换速度;网络包 pack,运算路径 align。”
面向对象高级特性
好的,我们来深入探讨 C++ 面向对象编程的高级特性。这些概念是构建复杂、可维护软件系统的基石。
1. 继承 (Inheritance)
继承是面向对象的核心特性,允许新的类(派生类 Derived Class)基于已有的类(基类 Base Class)来构建,继承其数据和行为,并可以进行扩展和特化。
a. 继承访问控制 (public/protected/private)
继承方式决定了基类成员在派生类中的最大访问权限以及派生类对象对基类成员的访问权限。
| 继承方式 | 基类public成员 |
基类protected成员 |
基类private成员 |
|---|---|---|---|
| public 继承 | Derived::public |
Derived::protected |
不可访问 |
| protected 继承 | Derived::protected |
Derived::protected |
不可访问 |
| private 继承 | Derived::private |
Derived::private |
不可访问 |
核心要点:
public继承 (is-a 关系): 最常用。表示派生类是基类的一种特化类型。它遵循”is-a”关系(Dogis anAnimal)。基类的公有接口也成为派生类的公有接口。1
2
3
4class Animal { public: void breathe(); };
class Dog : public Animal { public: void bark(); }; // Dog is an Animal
Dog d;
d.breathe(); // OK, public继承后,breathe()在派生类中仍是publicprotected/private继承 (is-implemented-in-terms-of 关系): 很少使用。它们不表示”is-a”关系,而是表示派生类是根据基类实现的(”is-implemented-in-terms-of”)。基类的公有和保护成员在派生类中都变成了protected或private,对外部不可见。1
2
3
4
5class Engine { public: void start(); };
// Car 不是一种 Engine,但它内部用了一个Engine来实现
class Car : private Engine { public: void turnKey() { start(); } };
Car c;
c.start(); // 错误!private继承后,start()在派生类中是private,外部无法调用通常,组合(在一个类中包含另一个类的对象作为成员)比
private/protected继承更优先被使用,因为它耦合度更低。
b. 虚继承 (Virtual Inheritance) 与 菱形继承 (Diamond Problem)
问题背景(菱形继承):
1
2
3
4
5
6
7
8
9class A { public: int data; };
class B : public A {};
class C : public A {};
class D : public B, public C {};
D d;
// d.data = 10; // 错误!歧义:不清楚data是来自B路径的A还是C路径的A
d.B::data = 10; // 需要显式指定,解决了语法歧义,但...
d.C::data = 20; // ...但B::data和C::data是**两个不同的副本**!造成了数据冗余。这种情况下,
D对象中包含了两份A的成员。解决方案(虚继承):
使用virtual关键字修饰继承关系,让B和C虚继承自A。这确保了在最终的派生类D中,只保留一份A的实例。1
2
3
4
5
6
7class A { public: int data; };
class B : virtual public A {}; // 虚继承
class C : virtual public A {}; // 虚继承
class D : public B, public C {};
D d;
d.data = 10; // OK!没有歧义,只有一份data副本实现机制: 虚继承通过虚基类指针和虚基类表来实现,编译器会安排让
B和C共享D中的同一块A子对象存储区域。最派生类(如D)负责直接初始化虚基类A。
2. 多态 (Polymorphism)
多态意为“多种形态”,允许使用统一的接口操作不同的对象。
a. 静态多态 (Static Polymorphism) vs 动态多态 (Dynamic Polymorphism)
| 特性 | 静态多态(编译时多态) | 动态多态(运行时多态) |
|---|---|---|
| 实现机制 | 函数重载 (Overloading)、模板 (Templates) | 虚函数 (Virtual Functions)、继承 |
| 绑定时间 | 编译期 | 运行期 |
| 性能 | 无额外运行时开销 | 有间接调用开销(查虚函数表) |
| 灵活性 | 相对较低 | 非常高,支持运行时动态绑定 |
示例:
静态多态(函数重载):
1
2void print(int i) { ... }
void print(double f) { ... } // 编译时根据参数类型决定调用哪个动态多态(虚函数):
1
2
3
4
5
6
7
8
9
10class Shape {
public:
virtual void draw() const = 0; // 纯虚函数,接口
};
class Circle : public Shape {
public:
virtual void draw() const override { ... } // 重写实现
};
Shape* s = new Circle;
s->draw(); // 运行时根据s实际指向的对象类型调用Circle::draw()
b. 虚函数实现机制
(此部分已在之前详述,此处简要回顾)
- vtable (虚函数表): 每个包含虚函数的类都有一个对应的 vtable。它是一个函数指针数组,存放该类所有虚函数的地址。
- vptr (虚函数指针): 每个包含虚函数的类的对象内部都有一个隐藏的 vptr 成员,指向其类的 vtable。
- 动态绑定过程:
obj->virtual_function()被编译器翻译为(*(obj->vptr[n]))(),其中n是虚函数在表中的索引。这实现了运行时根据对象实际类型调用正确函数。
3. 友元 (Friend)
友元机制打破了类的封装性,允许一个外部函数或另一个类访问本类的 private 和 protected 成员。
a. 友元函数 (Friend Function)
一个非成员函数被授予访问类的私有成员的权限。
1 | class Box { |
常见应用: 重载运算符(如 <<, >>),因为这些运算符通常需要作为非成员函数实现,但又需要访问类的私有数据。
b. 友元类 (Friend Class)
一个类被授予访问另一个类的私有成员的权限。
1 | class Sensor { |
注意: 友元关系是单向的(DataProcessor 可以访问 Sensor,但 Sensor 不能访问 DataProcessor)且不传递(DataProcessor 的友元不是 Sensor 的友元)。
c. 破坏封装性的权衡
- 优点: 提供了必要的灵活性,在某些场景下(如运算符重载、紧密协作的类)可以简化设计,提高效率。
- 缺点: 破坏了封装性和信息隐藏,增加了类之间的耦合度。友元关系在继承层次中也是不可继承的。
- 最佳实践: 慎用友元。优先考虑通过公有接口来交互。只有在确实无法通过公有接口高效、简洁地实现功能时,才考虑使用友元。
4. 运算符重载 (Operator Overloading)
运算符重载允许为用户自定义的类型(类或枚举)赋予运算符(如 +, -, ==, << 等)新的含义,使代码更直观。
a. 规则
- 不能发明新运算符(如不能定义
**来表示幂运算)。 - 不能改变运算符的优先级和结合性。
- 不能改变运算符的操作数个数(
++是单目,+是双目)。 - 至少有一个操作数是用户自定义类型(不能重载
int + int)。 ::,.*,.,?:这四个运算符不能被重载。
b. 常见重载
运算符重载可以定义为成员函数或非成员函数(通常是友元)。
作为成员函数: 运算符的左操作数必须是当前类的对象 (
this)。1
2
3
4
5
6
7
8
9
10class Vector {
public:
Vector operator+(const Vector& other) const { // 成员函数
return Vector(x + other.x, y + other.y);
}
private:
int x, y;
};
Vector v1, v2, v3;
v3 = v1 + v2; // 等价于 v3 = v1.operator+(v2);作为非成员友元函数: 当左操作数不是本类对象时(如
cout << myObject),必须定义为非成员函数。1
2
3
4
5
6
7
8
9
10class Vector {
// ... 同上
friend std::ostream& operator<<(std::ostream& os, const Vector& v);
};
std::ostream& operator<<(std::ostream& os, const Vector& v) {
os << "(" << v.x << ", " << v.y << ")";
return os; // 支持链式调用:cout << v1 << v2;
}
Vector v;
std::cout << v; // 调用 operator<<(cout, v);
一些常用运算符的重载建议:
=(赋值),[](下标),()(函数调用),->(成员访问): 必须作为成员函数重载。<<,>>(流操作): 必须作为非成员函数重载,且通常是友元。+,-,*,/,==,!=,<,>等: 通常作为非成员函数(以实现左右操作数对称性),或者成员函数。
c. 拷贝构造函数 (Copy Constructor)
它是一种特殊的构造函数,用于用一个已存在的对象来初始化一个新对象。编译器会为我们自动生成一个默认的拷贝构造函数(进行浅拷贝)。
语法: ClassName(const ClassName& other);
何时被调用?
- 用一个对象初始化另一个对象:
MyClass obj1; MyClass obj2 = obj1; - 函数参数传递对象(按值传递):
void func(MyClass obj); - 函数返回对象(按值返回)(可能会被编译器优化掉)。
为什么需要自定义拷贝构造函数?
当类中含有指针成员并管理着动态分配的内存时,默认的浅拷贝只会复制指针的值(地址),而不会复制指针所指向的内存。这会导致两个对象的指针成员指向同一块内存,从而引发双重释放和悬空指针问题。
解决方案:实现自定义拷贝构造函数进行深拷贝。
1 | class String { |
三法则 (Rule of Three): 如果一个类需要自定义析构函数、拷贝构造函数或拷贝赋值运算符,那么它很可能需要同时定义这三个。现代C++中,更推荐使用五法则 (Rule of Five),加上移动构造函数和移动赋值运算符。
现代C++(C++11/14/17)引入的这些革命性特性
1. 智能指针 (Smart Pointers)
智能指针是RAII(Resource Acquisition Is Initialization)理念的典范应用,用于自动化、安全地管理动态分配的内存,从根本上避免内存泄漏和悬空指针。
C++11主要引入了三种智能指针,位于 <memory> 头文件中:
std::unique_ptr: 独占所有权的智能指针。同一时间只能有一个unique_ptr指向一个对象。当unique_ptr被销毁时,它所指向的对象也会被自动销毁。无法被复制,只能被移动(std::move)。std::shared_ptr: 共享所有权的智能指针。通过引用计数机制,记录有多少个shared_ptr指向同一个对象。当最后一个shared_ptr被销毁时,对象才会被销毁。可以被复制。std::weak_ptr: 弱引用的智能指针。它指向由shared_ptr管理的对象,但不增加引用计数。用于解决shared_ptr的循环引用问题。
make_shared 和 make_unique
这是创建智能指针的推荐方式。
std::make_shared<T>(args...)(C++11): 构造一个T类型对象,并用args初始化它,然后返回一个指向此对象的std::shared_ptr<T>。1
2
3
4
5// 传统方式:可能引发内存泄漏(如果分配对象和构造shared_ptr之间发生异常)
std::shared_ptr<MyClass> sp1(new MyClass(10, 20));
// 推荐方式:异常安全且更高效(通常只需一次内存分配)
auto sp2 = std::make_shared<MyClass>(10, 20);std::make_unique<T>(args...)(C++14): 构造一个T类型对象,并用args初始化它,然后返回一个指向此对象的std::unique_ptr<T>。1
2
3
4
5// C++11中没有make_unique,需要自己构造
std::unique_ptr<MyClass> up1(new MyClass(30));
// C++14方式:异常安全,语法一致
auto up2 = std::make_unique<MyClass>(30);
优点:
- 异常安全: 函数参数的计算顺序可能在不同编译器下不同。如果使用
new,可能在分配内存和将裸指针交给智能指针之间发生异常,导致内存泄漏。make_*函数将这两步合并为一个原子操作,避免了这个问题。 - 性能提升(对
make_shared尤其明显):std::shared_ptr需要为控制块(存储引用计数等)和对象本身分配内存。使用new需要两次分配。而make_shared通常只进行一次内存分配,将对象和控制块放在连续的内存区域,提高了效率和局部性。
2. 移动语义 (Move Semantics)
移动语义是C++11最重要的特性之一,它允许资源的所有权转移,从而避免了不必要的深层拷贝,极大地提升了性能。
a. 右值引用 (Rvalue References)
- 语法:
Type&&,例如int&&。 - 目的: 用于标识“可被移动”的对象(临时对象、即将销毁的对象)。
- 左值 vs 右值:
- 左值 (lvalue): 有持久状态、有名字、可以取地址的表达式。例如变量、函数名、返回左值引用的函数调用。
- 右值 (rvalue): 临时对象、字面量(字符串字面量除外)、返回非引用类型的函数调用。例如
10,x + y,std::string("hello")。
b. std::move 语义
作用:
std::move(obj)并不移动任何东西。它只是一个强制类型转换,将左值obj无条件地转换为右值引用。这相当于告诉编译器:“这个对象不再需要了,你可以把它拥有的资源偷走(移动)”。示例:
1
2
3
4
5
6std::string str1 = "Hello";
std::string str2 = std::move(str1); // 调用string的移动构造函数
// 移动后,str1处于“有效但未定义的状态”(通常为空)
std::cout << str1; // 可能是空字符串,但不要做任何假设
std::cout << str2; // "Hello"
c. 移动构造函数和移动赋值运算符
为了让自定义类型支持移动语义,需要定义移动操作:
1 | class MyVector { |
d. 完美转发 (Perfect Forwarding)
问题: 如何在一个函数内部,将参数原封不动(保持其值类别:lvalue-ness / rvalue-ness)地传递给另一个函数?
解决方案:
std::forward<T>(arg)机制: 通常与通用引用(Universal Reference)
T&&结合使用在模板中。std::forward是一个有条件的std::move。如果传入的是一个左值,它返回左值引用;如果传入的是一个右值,它返回右值引用(相当于std::move)。应用场景: 工厂函数、
emplace_back等可变参数模板的实现。1
2
3
4
5template<typename T, typename... Args>
std::unique_ptr<T> make_unique(Args&&... args) { // 通用引用接收参数
// 完美转发给T的构造函数,保持参数原有的值类别
return std::unique_ptr<T>(new T(std::forward<Args>(args)...));
}
3. Lambda 表达式 (Lambda Expressions)
Lambda表达式提供了一种定义匿名函数对象的简便方法,极大地增强了STL算法的表达能力。
a. 语法
[capture-list] (parameters) -> return-type { body }
capture-list捕获列表: 指定lambda体内如何访问外部变量。parameters参数列表: 和普通函数一样(可选,可省略为())。return-type返回类型: 可以省略,编译器会自动推导(如果函数体只是return语句)。body函数体: 和普通函数一样。
b. 捕获列表 (Capture List)
定义了lambda表达式如何从外围作用域“捕获”变量。
[]: 不捕获任何外部变量。[=]: 以值的方式捕获所有外部变量。[&]: 以引用的方式捕获所有外部变量。[var]: 仅以值的方式捕获变量var。[&var]: 仅以引用的方式捕获变量var。[=, &var]: 默认以值捕获,但变量var以引用捕获。[&, var]: 默认以引用捕获,但变量var以值捕获。[this]: 捕获当前的this指针,允许访问所在类的成员。
注意: 默认值捕获 [=] 可能会带来问题,因为它捕获的是lambda定义时的变量值,而不是调用时的。而默认引用捕获 [&] 则可能导致悬空引用。
c. 应用场景
主要用于需要传递函数对象的地方,尤其是STL算法。
1 | std::vector<int> v = {1, 2, 3, 4, 5}; |
4. auto 和 decltype (Type Deduction)
a. auto
作用: 让编译器在编译期根据初始化表达式自动推导变量类型。
使用场景:
简化冗长或复杂的类型名: 特别是迭代器和模板代码。
1
2
3std::map<std::string, std::vector<int>> myMap;
// 不用写冗长的迭代器类型
auto it = myMap.find("key");泛型编程: 在不知道或不关心具体类型时。
1
for (const auto& pair : myMap) { ... } // 遍历map,pair的类型是std::pair<const std::string, ...>
Lambda表达式: 存储lambda对象(因为每个lambda类型都是唯一的、匿名的)。
1
auto func = [](int x) { return x * x; };
注意: auto 会忽略顶层的 const 和引用,如果需要,必须手动加上。
1 | const int ci = 10; |
b. decltype
作用: 查询一个表达式(而非初始化值)的确切类型,包括顶层的
const和引用。使用场景:
声明返回类型依赖于参数类型的函数(常与尾置返回类型
->一起使用)。1
2
3
4template<typename T, typename U>
auto add(T t, U u) -> decltype(t + u) { // C++11的用法,C++14可以省略->...
return t + u;
}在编译期获取表达式的类型,用于变量声明或元编程。
1
2
3int x = 0;
decltype(x) y = 10; // y 是 int 类型
decltype((x)) z = x; // z 是 int& 类型,因为 (x) 是一个左值表达式
5. constexpr (Constant Expressions)
constexpr 指定编译器在编译期就计算并确定变量或函数的值。
a. constexpr 变量
编译期常量,比 const 更严格。
1 | constexpr int size = 100; // 编译期常量 |
b. constexpr 函数
如果其参数是编译期常量,则函数会在编译期计算并返回结果;否则,它就像一个普通函数一样在运行时被调用。
1 | constexpr int factorial(int n) { // C++14允许函数体内有循环等语句 |
c. 模板元编程 (Template Metaprogramming)
constexpr 极大地简化了编译期计算,在很多场景下可以替代复杂、晦涩的模板元编程(TMP)。
1 | // 传统的模板元编程计算阶乘 |
总结: 这些新特性共同将C++推向了一个新时代,使得它既能保持底层硬件操作的能力和高性能,又能提供高级语言的开发效率和安全性。
小测试
十关总测验(闭卷,限时 30 min 😄)
指针与引用
写出一段代码:函数void foo(int*& p),在main()里用int x = 10;调用它,使得p最后指向x并打印出11。要求:不能出现*解引用运算符。类内 static
如何让class A的 static 成员A::count在头文件里声明,却在 main.cpp 里才定义,且保证其他 cpp 文件可见?写出声明+定义两行代码。类外 static
在a.cpp里写static int gs = 7;,在b.cpp里再写同样一句,会出现链接错误吗?为什么?new/delete 三部曲
手动实现一个最简my_shared_ptr<T>的引用计数部分(只需构造、拷贝、析构、释放内存,不用 weak_count)。要求用new分配控制块,用delete释放,禁止用std::任何东西。placement new
给定char buf[64];,在buf+7地址上构造一个std::string("hi"),然后安全析构。写出完整代码,并说明为什么不能用delete (std::string*)(buf+7)。智能指针混用
下面代码有严重问题,指出并给出两种修复方案:1
2
3
4auto sp = std::make_shared<int>(42);
std::thread t([](int* p){ std::this_thread::sleep_for(1s); std::cout << *p; }, sp.get());
sp.reset(); // 主线程立即重置
t.join();内存泄漏检测
用 Valgrind 跑./a.out时,如何只输出“确定泄漏”且把泄漏字节数≥10 的情况设为 CI 失败?写一行完整命令。字节对齐计算
64 位默认对齐下,给出sizeof(X)和alignof(X):1
struct X { char c; __int128_t v; double d; };
#pragma pack 与 alignas 冲突
1
2
3
struct alignas(16) S { int a; double b; };问:
sizeof(S)是多少?说明规则依据。综合场景
写一个线程安全的懒汉单例class Singleton,要求:- 使用
std::shared_ptr管理唯一实例; - 禁用拷贝构造、赋值;
- 在第一次调用
instance()时才创建; - 程序退出时自动释放,无内存泄漏。
只写关键 10 行代码即可。
- 使用
标准答案 + 评分细则
- 指针与引用(10 分)
要求:不出现*解引用,最后打印 11。
标准答案:
1 | void foo(int*& p) { ++p; } // p 本身是指针的引用,++p 让指针前移 4 字节(int) |
得分点:
- 没有
*解号(5 分) - 最终输出 11(5 分)
- 类内 static 声明与定义(10 分)
头文件:
1 | // A.h |
main.cpp:
1 |
|
得分点:
- 头文件用
static int count;(3 分) - cpp 用
int A::count = 9;(7 分)
- 类外 static 重复定义(10 分)
答案:不会链接错误,因为文件级static是内部链接,每个翻译单元拥有独立实体。
得分点:
- 答“不会”(5 分)
- 解释“内部链接/作用域独立”(5 分)
- 最简引用计数 my_shared_ptr(10 分)
核心 6 行:
1 | template<class T> |
得分点:
- 控制块用
new int(1)(3 分) - 拷贝++(2 分)
- 析构–并释放(5 分)
- placement new 构造与析构(10 分)
标准代码:
1 | alignas(std::string) char buf[64]; |
得分点:
- 正确使用 placement new(5 分)
- 手动调用析构(5 分)
- shared_ptr 与线程生命周期(10 分)
问题:主线程reset()后,子线程再解引用*p→ UB。
两种修复:
a) 把shared_ptr按值捕获到 lambda,让线程拥有独立拷贝。
b) 使用weak_ptr并在线程内lock()提升。
得分点:
- 指出 UB(5 分)
- 给出任意一种修复(5 分)
- Valgrind CI 阈值(10 分)
命令:
1 | valgrind --leak-check=full --errors-for-leak-kinds=definite \ |
(--errors-for-leak-kinds=definite 只把“确定泄漏”视为错误;泄漏字节数≥1 即返回 1)
得分点:
- 写出
--error-exitcode=1(5 分) - 限定
definite泄漏(5 分)
- 对齐计算(10 分)
1 | struct X { char c; __int128_t v; double d; }; |
alignof(X)= 16(__int128_t要求 16)sizeof(X)= 32(c:1 + pad15 + v:16 + d:8 + pad8 → 对齐到 16 边界)
得分点:sizeof32(5 分)alignof16(5 分)
- pack 与 alignas 冲突(10 分)
1 |
|
规则:alignas 不会被 #pragma pack 缩小;最终对齐取 max(pack, alignas)。
- 实际对齐 = 16
- 大小 = 16(a:4 + pad4 + b:8 → 总 16,已 16 对齐)
得分点: - 答
16(5 分) - 解释“alignas 优先级高”(5 分)
- 线程安全 shared_ptr 单例(10 分)
关键 10 行:
1 | class Singleton { |
得分点:
- 静态局部
shared_ptr(4 分) - 禁用拷贝(2 分)
- 返回引用避免重复拷贝(4 分)
总分 100,自己算分吧!
把错题发回来,我再给你补细节 😄